Embeddings, RAG et agents IA : comment ça marche
Les embeddings sont la brique invisible qui permet à une intelligence artificielle de retrouver la bonne information dans vos documents. Un embedding transforme un texte, une image ou un son en vecteur, une suite de nombres qui représente sa signification. Deux textes proches par leur signification ont des vecteurs proches. Sur ce principe reposent la recherche sémantique, le RAG (retrieval augmented generation) et les agents IA qui travaillent sur les connaissances de l’entreprise. Cet article explique comment fonctionnent les embeddings et à quoi ils servent, concrètement.
L’essentiel
- Un embedding représente un contenu (texte, image, audio) par un vecteur de nombres qui capture sa signification.
- Des contenus similaires ont des embeddings proches, et la recherche sémantique repose sur cette propriété.
- Le RAG utilise les embeddings pour retrouver les bons documents, puis un modèle de langage pour rédiger la réponse.
- Les agents IA s’appuient sur le RAG pour agir avec les connaissances de l’entreprise.
Sommaire
Qu’est-ce qu’un embedding ?
En machine learning, un embedding est une représentation d’un objet (un terme, une phrase, un document, une image) par un vecteur, c’est-à-dire une liste de nombres. Personne ne fixe ces nombres à la main. Un modèle entraîné les calcule, de sorte que des objets de signification proche aient des vecteurs proches.
Prenons un exemple. Le modèle d’embedding reçoit un input, ici la phrase « délai de livraison dépassé », et produit un vecteur de plusieurs centaines ou milliers de dimensions. La phrase « commande arrivée en retard » produira un vecteur très similaire, alors qu’elle n’a aucun terme en commun avec la première. La recherche sémantique se distingue ainsi de la recherche par termes exacts.
Les notions clés
- Vecteur (vector) : la suite de nombres qui représente un contenu.
- Dimensions : le nombre de valeurs du vecteur, souvent plusieurs centaines ou milliers.
- Similarité : la proximité entre deux vecteurs, calculée par exemple avec la similarité cosinus.
- Vector database : l’entrepôt qui stocke les vecteurs et retrouve les plus proches d’une requête.
Comment sont créés les embeddings
Les embeddings sont produits par des models de deep learning, des réseaux de neurones (neural networks) entraînés sur de très grands volumes de données. Les premiers modèles célèbres, comme Word2Vec, représentaient des termes isolés. Les modèles actuels, issus de l’architecture Transformer, représentent des phrases et des documents entiers en tenant compte du contexte.
Les grands éditeurs proposent des modèles d’embedding accessibles par API (OpenAI, Mistral, Google, Cohere), et de nombreux models open source sont disponibles sur Hugging Face. Le choix dépend de la langue, de la performance attendue, du coût et de l’endroit où les données doivent être traitées. Pour des documents en français, il faut vérifier la qualité du modèle sur cette langue.
Au-delà du texte
Il existe aussi des embeddings d’images, de sons et de code, ainsi que des modèles dits multimodaux qui placent textes et images dans un même espace. On peut alors rechercher une image avec une simple description en texte.
Le vocabulaire anglais des embeddings
La documentation technique sur les embeddings est presque entièrement en anglais. Les termes suivants y reviennent souvent, avec ce qu’ils désignent.
- Embeddings, vectors : les représentations d’un contenu par une liste de nombres ; on parle aussi de vector embeddings ou de text embeddings pour le texte.
- Embedding space (ou latent space) : l’espace à plusieurs dimensions dans lequel sont placés les vecteurs ; plus deux points de cet space sont proches, plus les contenus se ressemblent.
- Number of dimensions : la dimension du vecteur, c’est-à-dire le nombre de valeurs qui le composent.
- Semantic search : la recherche par signification, qui retrouve des similar items même formulés autrement.
- Neural network désigne le réseau de neurones qui calcule les embeddings, entraîné par machine learning sur de grands volumes de data.
- Input désigne le contenu fourni au modèle (un texte, une image), dont le vecteur produit est la sortie.
- Large language model (LLM) désigne le modèle de langage qui rédige la réponse dans un process de RAG.
- Retrieval : l’étape de recherche des passages les plus proches de la question.
Un exemple souvent cité aide à comprendre les embeddings. Dans un bon modèle, le vecteur de « roi », moins celui d’« homme », plus celui de « femme », produit un vecteur proche de celui de « reine ». Les représentations capturent ainsi des relations de signification. Les applications d’entreprise emploient surtout des embeddings de phrases et de documents. La performance d’un assistant RAG dépend alors directement de la qualité de ces représentations, et du choix de modèles adaptés à la langue et au domaine, par exemple un vocabulaire juridique ou technique spécialisé.
À quoi servent les embeddings
- La recherche sémantique retrouve les documents qui répondent à une question, même formulée autrement.
- Le RAG fournit à un modèle de langage les passages utiles pour répondre avec les documents de l’entreprise.
- La classification range automatiquement des courriels, des tickets, des documents.
- La détection de doublons repère des contenus similaires dans une grande collection.
- La recommandation propose des produits ou des contenus proches de ceux qu’un client apprécie.
Le RAG : embeddings et modèles de langage
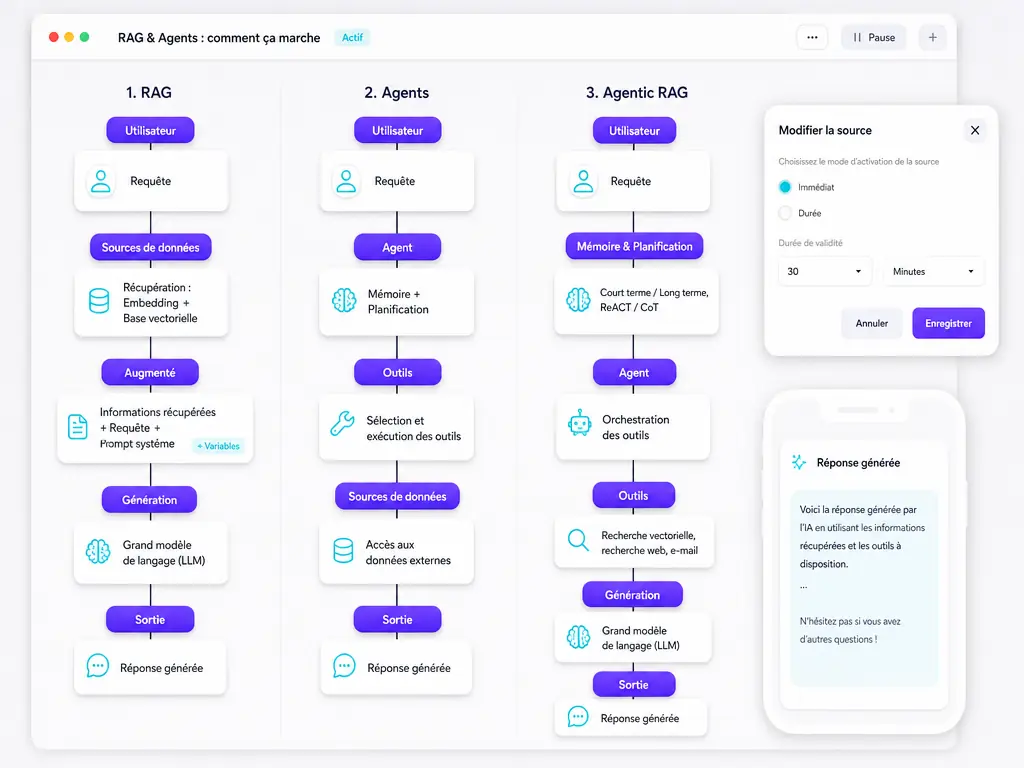
Le RAG, pour retrieval augmented generation (génération augmentée par la recherche), combine deux briques, la recherche sémantique par embeddings et un grand modèle de langage (LLM). Cette technique est la plus utilisée pour construire un assistant qui répond sur les documents de l’entreprise.
- Préparation. Les documents de l’entreprise sont découpés en passages, et chaque passage est transformé en embedding, stocké dans une vector database.
- Question. L’utilisateur pose une question, elle aussi transformée en embedding.
- Recherche. Les passages dont les vecteurs sont les plus similaires sont retrouvés.
- Génération. Ces passages sont fournis au modèle de langage, qui rédige une réponse fondée sur eux, avec leurs références.
Grâce au RAG, le modèle répond avec les informations à jour de l’entreprise sans avoir été réentraîné, et il peut citer ses sources. Les droits d’accès sont respectés si la recherche ne porte que sur les documents que l’utilisateur est autorisé à consulter.
| Modèle seul | Modèle avec RAG | |
|---|---|---|
| Connaissances | Générales, figées à la date d’entraînement | Documents de l’entreprise, à jour |
| Sources citées | Rarement | Oui |
| Risque d’invention | Plus élevé | Réduit |
| Droits d’accès | Sans objet | Respectés si bien configurés |
Des embeddings aux agents IA
Un agent IA va plus loin qu’un assistant. Il enchaîne plusieurs actions pour atteindre un objectif, en utilisant des outils (logiciels, API, recherches). Le RAG compte parmi ces actions. Avant d’agir, l’agent recherche les informations pertinentes dans les connaissances de l’entreprise. Un agent de service client, par exemple, retrouve la procédure applicable, consulte l’historique de la commande, puis prépare une réponse que le conseiller valide.
Pour se connecter aux outils, les agents s’appuient de plus en plus sur des protocoles standards comme le Model Context Protocol, détaillé dans notre article le protocole MCP expliqué.
Bien réussir un projet de RAG
- Des documents à jour et bien structurés, car la qualité des réponses dépend de celle des sources.
- Un découpage adapté des documents en passages, ni trop courts ni trop longs.
- Un modèle d’embedding performant dans la langue des documents.
- Le respect des droits d’accès de chaque utilisateur.
- Une évaluation régulière de la pertinence des réponses, avec les utilisateurs.
- Un hébergement maîtrisé des documents et des vecteurs, en Europe pour les données sensibles.
Korbyx conçoit et déploie des assistants RAG et des agents IA sur les documents de ses clients. Vous trouverez le détail dans notre cas d’usage base de connaissances IA (RAG), nos services assistant IA interne, création d’agents IA, développement sur mesure et IA souveraine, ainsi que sur notre page sécurité.
Les mêmes techniques servent d’autres usages, comme la FAQ intelligente, l’agent IA service client, l’analyse de documents, le ticketing, l’intégration des nouveaux salariés ou le service RH interne. Sur un sujet voisin, lisez aussi les prompts IA pour les dirigeants.
Références14
- Mikolov et al., 2013 : Word2Vec, les premiers embeddings de termes.
- Vaswani et al., 2017 : l’architecture Transformer.
- Lewis et al., 2020 : l’article fondateur du RAG.
- OpenAI : documentation des embeddings.
- Mistral AI : embeddings de Mistral.
- Google : embeddings de Gemini.
- Cohere : modèles d’embeddings multilingues.
- MTEB : le classement de référence des modèles d’embeddings.
- Hugging Face : models open source.
- Sentence Transformers : embeddings de phrases.
- FAISS : recherche de similarité à grande échelle.
- Pinecone : introduction aux vector embeddings.
- Model Context Protocol : le protocole de connexion des modèles aux outils.
- CNIL : IA et protection des données.
FAQ
Questions fréquentes.
Qu’est-ce qu’un embedding ?
Une représentation d’un contenu (texte, image, audio) par un vecteur de nombres, calculé par un modèle de machine learning pour que des contenus de signification proche aient des vecteurs proches.
À quoi servent les embeddings ?
À la recherche sémantique, au RAG, à la classification, à la détection de doublons et à la recommandation.
Qu’est-ce que le RAG ?
La retrieval augmented generation. Un modèle de langage répond en s’appuyant sur des passages de documents retrouvés par recherche sémantique, et il cite leurs sources.
Faut-il une vector database ?
Pour un grand nombre de documents, oui. Elle stocke les vecteurs et retrouve rapidement les plus similaires. Sur un petit volume, une solution plus simple peut suffire.
À propos de l’auteur
Korbyx conçoit et déploie des assistants et des agents IA sur les documents des PME et des ETI. Les données restent hébergées en Europe, et chaque utilisateur n’accède qu’à ce que son rôle autorise.
À lire ensuite
Pour aller plus loin.
Quelle formation IA choisir ?
L’offre de formation en intelligence artificielle a explosé, en ligne ou en présentiel, courte ou certifiante, éligible au CPF ou financée par l’entreprise. Pour…Lire l’article
Applications IA : panorama et par où commencer en entreprise
Les applications IA se sont multipliées, des assistants conversationnels aux générateurs d’images et de vidéo, en passant par la prise de notes, la traduction,…Lire l’article
Le protocole MCP expliqué : connecter l’IA à vos outils
Le protocole MCP, pour Model Context Protocol, est un standard ouvert qui permet de connecter les modèles d’intelligence artificielle aux outils et aux données…Lire l’articleUn assistant qui connaît vos documents.
En 60 minutes, un fondateur examine avec vous ce qu’un assistant RAG peut faire de vos documents internes. Sans engagement.