OCR par l’IA
Vos documents scannés, lus et compris automatiquement.
L’OCR par l’IA lit vos documents scannés, vos fichiers PDF, vos images et vos formulaires, puis permet d’extraire les données qui vous intéressent, numéros, montants, dates et références. Là où l’OCR classique se contentait de transformer une image en texte brut, l’OCR par intelligence artificielle comprend la structure du document et rend des données directement exploitables dans vos logiciels. Reste à savoir ce que cette technologie OCR sait traiter, avec quelle précision, et ce qu’on en fait ensuite. Découvrez comment extraire une donnée fiable à partir de documents que personne n’a envie de saisir, avec une technologie de pointe devenue accessible.
- Hébergé en Europe
- Aucun outil à remplacer
- Validation humaine
412 bons de livraison6 incomplets
KorbyxEn direct
Quels bons de livraison sont illisibles ou incomplets ?
Six sur 412 : quatre sans signature et deux photos floues. Une demande de nouvelle copie est prête pour chaque fournisseur.
Demander les copies- 1 heure par jourc’est le temps que l’IA fait gagner en moyenne sur les tâches répétitives, et jusqu’à 2 heures pour un salarié sur cinq (étude Adecco, 35 000 salariés, 27 pays, 2024). La saisie de documents en fait partie, et c’est l’une des plus faciles à automatiser grâce à l’OCR
- 95 à 99 %la précision d’extraction que nous obtenons sur des documents structurés, factures et bons de livraison. Sur des écritures manuscrites ou des mises en page complexes, la précision baisse et le contrôle humain reste nécessaire, quelle que soit la solution retenue
- De l’image à la donnéeun OCR classique rend du texte. Un OCR par IA rend des données structurées, avec le numéro de facture dans le bon champ, le montant dans le bon format et la référence rattachée au bon fournisseur. Une extraction de données prête à l’emploi, sans retouche
Ils pilotent avec Korbyx

 Stade Rennais


 Stade Rennais
La différence
L’OCR classique lit, l’OCR par IA comprend.
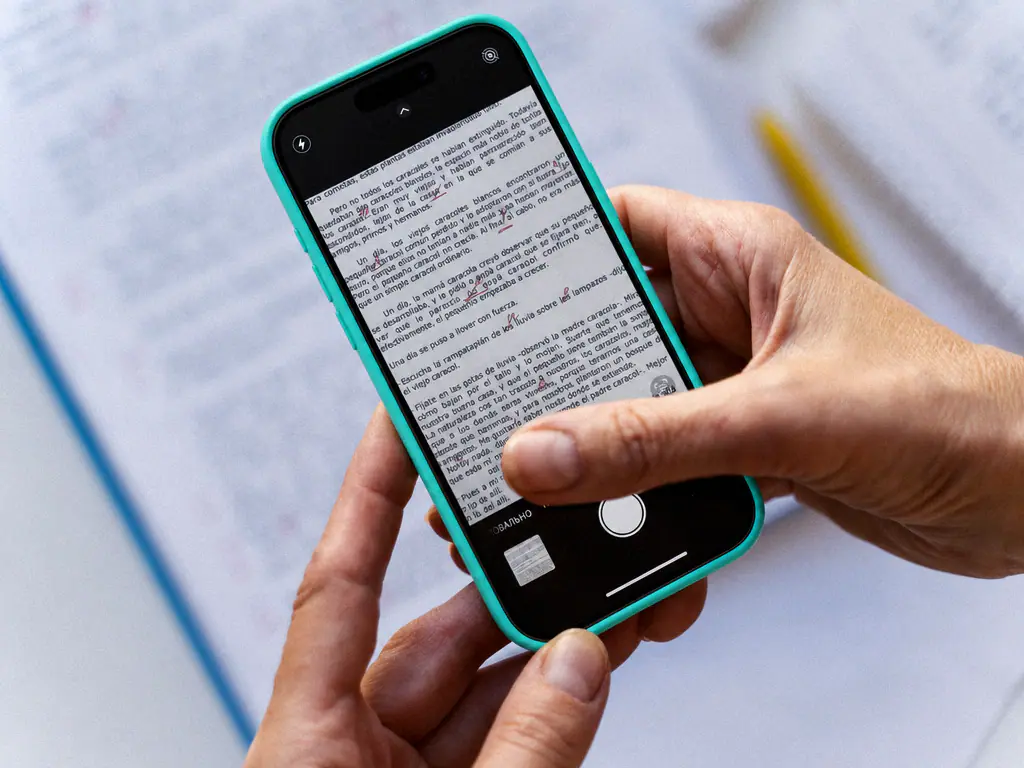
Les deux technologies portent le même nom et ne rendent pas le même service. Un OCR classique reconnaît des caractères, y compris sur des images, et produit un bloc de texte. Un OCR par intelligence artificielle identifie en plus la structure du document et sait quelle information se trouve où.
Prenons une facture fournisseur scannée. L’OCR classique vous rend l’intégralité du texte, dans l’ordre où il apparaît sur la page, et c’est ensuite à vous de retrouver le numéro, la date et le total. Sur un flux de quelques documents par semaine, cette utilisation peut suffire. À grande échelle, sur plusieurs centaines de fichiers, le travail de tri annule le gain, et beaucoup d’entreprises abandonnent à ce stade en concluant que l’OCR ne marche pas, alors que c’est l’outil qui n’était pas le bon.
L’OCR par intelligence artificielle change la nature du résultat. Il rend un jeu de données structurées, prêt à écrire dans votre logiciel de gestion, quel que soit le format du fichier d’origine, PDF ou image. Chaque valeur extraite garde un lien vers l’endroit exact du document d’origine, ce qui permet à une personne de vérifier en un coup d’oeil plutôt que de tout relire. Cette traçabilité rend l’automatisation acceptable pour une équipe comptable, et elle manque à la plupart des solutions gratuites, aussi rapides soient-elles.
- L’OCR classique rend du texte brut, dans l’ordre de la page
- L’OCR par IA rend des données structurées, champ par champ
- Chaque donnée extraite reste reliée à sa source dans le document
- Le contrôle se fait par exception, pas sur la totalité du flux
| Ce que vous avez | OCR classique | OCR par IA |
|---|---|---|
| Une facture scannée | un bloc de texte à relire | numéro, date, montant, fournisseur, dans les bons champs |
| Un formulaire rempli à la main | des caractères souvent faux | les réponses extraites, avec un indice de confiance par champ |
| Un contrat de trente pages | trente pages de texte | les clauses repérées, les dates clés, les montants |
| Un lot d’archives hétérogènes | un résultat inutilisable | un classement par type de document, puis l’extraction adaptée à chacun |
Le même document, traité par deux technologies différentes.
Ce qu’on traite
Les documents que l’OCR par IA sait lire.
Six familles couvrent la quasi-totalité des flux de traitement de documents que nous reprenons en PME, de l’industrie à la finance. La précision d’extraction dépend surtout de la régularité de la mise en page, beaucoup moins du volume, et ces cas d’utilisation se ressemblent d’une entreprise à l’autre.
- Factures
- Bons de livraison
- Contrats
- Formulaires
- Courriers
- Archives
Les factures fournisseurs
Le flux le plus fréquent, et celui qui rend le plus vite. Numéro, date, montants, taxes, références de commande, coordonnées du fournisseur. La précision dépasse souvent 98 % dès lors que le format se répète d’une facture à l’autre, même sur des fichiers PDF de qualité moyenne.
Les bons de livraison
Souvent froissés, tamponnés, signés à la main. L’extraction porte sur les quantités et les références, puis le rapprochement avec la commande se fait automatiquement. Les écarts remontent, le reste passe seul. De quoi automatiser un flux entier sans y penser.
Les contrats et conditions
Ici, la lecture compte davantage que la saisie. L’IA repère les dates d’échéance, les clauses de reconduction, les plafonds, et permet de retrouver une information à partir de documents représentant plusieurs milliers de pages.
Les formulaires
Bulletins d’inscription, questionnaires, fiches d’intervention, souvent transmis en images prises au téléphone. Les écritures manuscrites restent le cas le plus difficile. Comptez un indice de confiance par champ et un contrôle humain sur ce qui passe sous le niveau de confiance retenu. Les modèles progressent vite sur ce terrain, mais l’aide d’une personne reste utile.
Les courriers entrants
Le premier gain tient au tri davantage qu’à l’extraction. Identifier le type de courrier, le rattacher au bon dossier client, l’envoyer au bon service. Le reste du flux de travail suit dans vos outils habituels, sans rien changer aux habitudes.
Les archives
Des cartons entiers de documents imprimés, numérisés en PDF, que personne ne consulte parce que personne ne peut les chercher. Une fois numérisés et indexés, ils redeviennent une base de connaissances interrogeable en langage naturel, qui sait répondre à une question posée en français.
Comment ça marche
De l’image scannée à la donnée dans votre logiciel.
Quatre temps suffisent à décrire le traitement, et l’essentiel du travail se joue sur les deux derniers. La reconnaissance de caractères, elle, est devenue une technologie OCR banale, disponible chez tous les grands fournisseurs de cloud, et pour un coût modique.
On commence par la numérisation et le nettoyage des images, avec redressement, contraste et découpage des pages. Un OCR moderne gère seul cette étape. Vient ensuite la reconnaissance proprement dite, qui transforme les pixels en caractères et en mots. Ces deux étapes de l’OCR sont automatiques et le traitement est rapide. Elles ne demandent aucun réglage particulier sur des fichiers PDF ou sur des images de qualité correcte. La plupart des langues européennes sont couvertes, et l’utilisation de plusieurs langues dans un même document ne pose pas de problème.
La troisième étape sépare une solution utile d’une curiosité. L’intelligence artificielle analyse la mise en page, comprend qu’il s’agit d’une facture ou d’un bon de livraison, et va chercher les informations attendues à l’endroit où elles se trouvent, quelle que soit la présentation du fournisseur. La quatrième raccorde le tout à vos applications par API, pour que la donnée extraite s’écrive directement dans votre outil de gestion. Cette API rend les données dans un format standard, du JSON le plus souvent, et la même API absorbe de gros volumes de documents sans intervention ni code supplémentaire. Nous décrivons ce travail sur l’intégration de l’IA, et sans lui l’OCR ne fait que déplacer le problème.
- Numériser et nettoyer : redressement, contraste, découpage
- Reconnaitre : les pixels deviennent des caractères et des mots
- Comprendre : l’IA identifie le type de document et localise les informations
- Écrire : la donnée part dans votre logiciel par API, sans ressaisie
Ce qui suit
L’extraction n’est que le début.
Une fois les données sorties du document, six automatisations deviennent possibles, et nous les mettons en place couramment.
Le contrôle automatique
Comparer le montant extrait à la commande, vérifier que le taux de taxe correspond au pays, repérer un doublon. Aucune personne n’a besoin de gérer ces contrôles à la main. Ils portent sur la totalité du flux plutôt que sur un sondage, et les écarts seuls remontent.
Le classement
Chaque document part au bon endroit, avec son type, sa date, son client et son dossier. La recherche documentaire redevient possible, y compris sur des fonds anciens que plus personne n’ouvrait, et vos textes redeviennent une matière vivante.
L’écriture dans vos outils
La donnée s’écrit dans votre logiciel de gestion, votre outil comptable ou votre gestion commerciale. Le gain se mesure là, et nulle part ailleurs, puisque la ressaisie disparaît complètement.
La relance et le suivi
Un document extrait et daté déclenche la suite, relance d’un impayé, rappel d’échéance, alerte sur une date de reconduction. Le document cesse d’être un point d’arrivée et devient le déclencheur des produits et des services que vous rendez.
La recherche en langage naturel
Une fois indexés, vos documents répondent aux questions posées en français, en citant leur source, sur un site interne accessible à tous. La base de connaissances interne fonctionne sur ce principe, et l’OCR en est le préalable.
Le suivi de conformité
Savoir quels documents ont été traités, par qui et quand. Un journal complet des extractions et des corrections, indispensable dès que des informations sensibles circulent, et une exigence de confidentialité que nous savons tenir.
La plateforme Korbyx
Korbyx vous dit où regarder.
Plusieurs écrans, une seule base de données. Chaque écran répond à une question que vous vous posez déjà.
Toutes vos agences, comparées entre elles
Chaque agence est comparée à la médiane de ses pairs, dans votre propre réseau. Vous voyez lesquelles tournent bien, lesquelles décrochent, et de combien.
Devis transformés, trois derniers moisMédiane du réseau · 43 %
Lyon Est est à 29 %, soit 14 points sous la médiane. Plan d’action proposé.
Résultat
3 agences à traiter, détectées ce matin
- médiane du réseau
- 43 %médiane du réseau
- écart le plus fort
- −14 ptsécart le plus fort
- agences sous la médiane
- 3 / 60agences sous la médiane
- de consolidation évitées
- 6 hde consolidation évitées
- Plan d’action proposé pour Lyon Est
- Animateur prévenu, visite jeudi
Des questions en langage courant
La réponse cite la mesure, la période et la source. Quand la donnée manque, Korbyx le dit.
Combien a-t-on facturé en septembre, par région ?
2,1 M€, dont 38 % pour la région Ouest. Le Sud-Est recule de 9 % sur un an, surtout à Lyon Est et Dijon Centre.
Mesure : CA facturé, v3Période : septembre 2026Source : ERP
Et la marge ?
La marge par région n’est pas encore connectée. Je peux vous montrer le chiffre d’affaires ou la marge du réseau entier.
Résultat
2,1 M€ facturés en septembre
- Réponse en 4 secondes, source citée
- Sud-Est : −9 % sur un an, à suivre
Il écrit dans vos outils
Relance préparée, tâche créée dans le CRM. Vous validez, l’action part.
CRM · Nouvelle tâchepréparée par Korbyx
Relancer M. Garnier, devis n° 2026-118 (14 200 €)
Bonjour Monsieur Garnier, je reviens vers vous au sujet de notre proposition du 2 septembre…
Échéance jeudi · C. DurandValiderValidée
Journal des actions
- Tâche écrite dans le CRM, 09:42
- Responsable prévenue, 09:42
- Point de suivi prévu vendredi
Résultat
Cette semaine, sur vos relances
- relances envoyées
- 14relances envoyées
- clients ont répondu
- 6clients ont répondu
- devis signés
- 3devis signés
- encaissés ou signés
- 42,6 k€encaissés ou signés
- Toutes validées par un humain
- Écrites dans le CRM, rien à ressaisir
Données d’illustration.
Vos flux
Quels documents valent la peine d’être repris.
Un fondateur vous consacre 60 minutes. On compte vos documents, on repère les formats qui se répètent, et vous repartez avec une estimation du temps récupéré.
- 60 minutes
- Avec un fondateur
- Sans engagement
Les limites
Ce que l’OCR par IA ne sait pas faire.
Autant le dire tout de suite, la précision annoncée par les éditeurs de solutions OCR se mesure sur des documents propres et réguliers. Sur vos archives, sur des écritures manuscrites ou sur des mises en page complexes, elle baisse, et il faut le prévoir dans l’organisation.
En matière d’OCR, les trois cas difficiles sont connus. Les documents manuscrits d’abord, où la précision dépend de l’écriture et où un contrôle humain reste nécessaire sur les champs critiques. Les mises en page complexes ensuite, tableaux imbriqués, colonnes multiples, annotations dans les marges. Les documents dégradés enfin : photocopies de photocopies, fax anciens, images de mauvaise qualité. Aucun modèle ne fait de miracle sur un texte illisible. Dans ces trois situations, l’IA reste une aide utile mais elle propose plutôt qu’elle ne tranche.
La bonne façon d’organiser cela est le traitement par exception. Chaque valeur extraite porte un indice de confiance ; au dessus du seuil, elle passe seule ; en dessous, elle part dans une file de vérification où une personne confirme rapidement, document original affiché à côté. La vérification complète prend quelques secondes. Les entreprises qui procèdent ainsi traitent une grande partie de leur flux sans intervention, souvent 80 à 90 %, ce qui suffit largement à rentabiliser le projet. Le calcul se fait comme pour tout usage de l’IA, sur comment calculer le ROI de l’IA.
- Manuscrit : précision variable, contrôle humain sur les champs critiques
- Mises en page complexes : tableaux imbriqués, colonnes, annotations
- Documents dégradés : la qualité de la numérisation commande tout
- Traitement par exception : seul ce qui doute est vérifié
« La question n’est pas de savoir si l’OCR se trompe, il se trompe. La question est de savoir s’il sait dire qu’il doute. Un système qui rend un indice de confiance par champ est utilisable ; un système qui rend tout avec le même aplomb ne l’est pas. »
FAQ
Questions fréquentes sur l’OCR par intelligence artificielle.
Qu’est-ce que l’OCR par IA ?
Une technologie qui lit un document numérisé et en extrait les informations utiles sous forme de données structurées. Là où l’OCR traditionnel rend un bloc de texte, l’OCR par intelligence artificielle comprend la structure du document et sait que tel nombre est un montant, telle chaîne une référence de commande. Le résultat s’écrit directement dans vos logiciels, sans passer par un export intermédiaire.
Quelle précision peut-on attendre ?
Entre 95 et 99 % sur des documents structurés et réguliers comme des factures, à condition que la numérisation soit correcte. La précision baisse sur les écritures manuscrites et sur les mises en page complexes. Nous travaillons donc toujours avec un indice de confiance par champ, qui déclenche une vérification humaine sous un certain seuil. Ce choix optimise le rapport entre vitesse et fiabilité.
Faut-il un scanner particulier ?
Non. Un scanner de bureau ou même une photo prise au téléphone suffisent dans la plupart des cas, et le résultat est rapide. La qualité de l’image compte davantage que le matériel, car un document bien à plat, correctement éclairé et net donne de meilleurs résultats qu’un scan à haute résolution mal cadré. Les images prises de travers sont redressées automatiquement.
Que deviennent nos documents pendant le traitement ?
Vos data restent sur une infrastructure hébergée en Europe et cloisonnée par client, et elles ne servent à entraîner aucun modèle. Posez la question à chaque fournisseur d’OCR que vous consultez, car beaucoup de services grand public se réservent, dans leurs conditions d’utilisation, des droits étendus sur vos data. Lisez cette politique avant d’y déposer un contrat. Nos engagements de confidentialité sont détaillés sur la sécurité du socle.
Combien de documents faut-il pour que ce soit rentable ?
Faites ce calcul avant de choisir. Le seuil se situe autour de quelques centaines de documents par an et par format, dès lors que la saisie prend plus de deux minutes par document. En dessous, une reprise manuelle reste plus économique. Au dessus, le gain devient évident, et il grandit avec le volume puisque le coût de traitement unitaire baisse.
Peut-on traiter plusieurs types de documents à la fois ?
Oui, et c’est même le mode normal. L’application commence par identifier le type de chaque document entrant, puis applique l’extraction adaptée. Les modèles distinguent une facture d’un bon de livraison sans qu’on ait à le leur dire. Cette reconnaissance préalable permet de brancher un flux hétérogène, courrier entrant ou boîte aux lettres de facturation, sans trier en amont. À propos du volume, la montée en charge ne demande aucun réglage supplémentaire.
Secteurs et cas d’usage
Secteur par secteur, métier par métier.
Vos agences, vos chantiers, vos tournées, vos établissements : ce que Korbyx change, dans votre métier.
 SecteurAdministrateurs de biensGestion locative et copropriété.Découvrir
 SecteurAgroalimentaireDes matières premières à l'assiette.Découvrir
 Cas d'usageTout le savoir de votre entreprise, interrogeable en une question.Découvrir
 Guide · 14 minQuelle formation IA choisir ?Lire le guide
 SecteurAgences immobilièresPlus de temps pour les clients.Découvrir
 SecteurBTPDu bureau d'études au chantier.Découvrir
 Cas d'usageVos documents, lus et compris.Découvrir
 Guide · 12 minMaintenance prédictive : exemples concretsLire le guide
 Cas d'usageVos factures fournisseurs, lues et contrôlées seules.Découvrir
 SecteurÉducationUtile, encadrée, pédagogique.Découvrir
 Cas d'usageAnimez votre réseau multi-sites depuis un seul poste de pilotage.Agences, magasins, franchisés, points de vente.Découvrir
 Guide · 17 minComparatif IA 2026 pour les PMELire le guide
 SecteurCabinets d'auditPlus de temps pour le jugement professionnel.Découvrir
 SecteurHôtellerieAu service de l'expérience client.Découvrir
 Cas d'usageDétectez les défauts avant qu'ils ne quittent l'usine.Découvrir
- Cas d'usageVos impayés se relancent tout seuls.Relances rédigées, vous validez, elles partent.
 SecteurIntérim et recrutementDécouvrir
 SecteurIndustrieDe l'atelier à la décision.Découvrir
 Cas d'usageLes faux documents ne passent plus.Découvrir
 Guide · 10 minChatGPT ou Copilot en entreprise ?Lire le guide
 Cas d'usageUne FAQ intelligente qui répond depuis vos vrais documents.Vos clients posent les mêmes questions, jour après jour, et votre équipe y répond à la main.Découvrir
 SecteurLaboratoiresAu service des biologistes et des patients.Découvrir
 Cas d'usageLe devis part le jour même, pas la semaine d'après.Un client vous décrit son besoin par email ou au téléphone.Découvrir
- Cas d'usageToutes vos agences, comparées.Animez un réseau multi-sites depuis un seul poste.
 SecteurÉtudes notarialesAu service de l'acte authentique.Découvrir
 SecteurMédiasAu service de l'information et du journalisme.Découvrir
 Cas d'usageLisez vos plans, chiffrez plus vite.Découvrir
 Guide · 12 minFacture électronique obligatoire : le guide PMELire le guide
 Cas d'usageVos interventions pilotées, du planning au compte rendu.Découvrir
 SecteurPharmacieDe la recherche à la production.Découvrir
 Cas d'usageVotre marketing branché sur vos vraies données.L'IA marketing ne se résume pas à produire du contenu plus vite.Découvrir
- Cas d'usageMarge et trésorerie, en continu.Le pilotage financier sans attendre la clôture.
 Cas d'usageMesurez votre OEE, en temps réel.Découvrir
 SecteurAéronautiqueDe l'atelier à l'exploitation.Découvrir
 Cas d'usageDécider vite, sur des données réelles.Découvrir
 Guide · 8 minMistral AI ou ChatGPT ?Lire le guide
 Cas d'usageVos données éparses, transformées en décisions.Découvrir
 SecteurAssuranceAu service des assurés et des équipes.Découvrir
 SecteurAgences de communicationPlus de temps pour la créativité.Découvrir
 SecteurE-commerceDe la recherche à la livraison.Découvrir
 Cas d'usageAnticipez au lieu de constater.Découvrir
 SecteurFinanceDes chiffres fiables, des décisions rapides.Découvrir
 SecteurBureaux d'étudesPlus de temps pour l'ingénierie.Découvrir
 SecteurMétallurgieDes procédés mieux maîtrisés.Découvrir
Pour aller plus loin
Poursuivre sur le traitement documentaire.
- Cas d’usageTous les cas d’usage
- Cas d’usageBase de connaissances interne
- Cas d’usageAnalyse de documents par l’IA
- Cas d’usageAnalyse des factures
- ServiceAutomatisation des processus métier
- ServiceAutomatisation des tâches
- ServiceIntégration à vos applications
- ServiceDéveloppement sur mesure
- PlateformeSécurité et souveraineté
- Budget et ROIComment calculer le ROI de l’IA
- PrixCombien coûte un projet d’IA
- ServiceL’audit IA, le point de départ
- ServiceAssistants IA internes
- Cas d’usageMaintenance prédictive par l’IA
Transformons votre papier en données exploitables.
Un premier contact de 60 minutes avec un fondateur, vos volumes et vos formats sur la table, un périmètre estimé à la sortie. Rien à signer.